AI in de praktijkGepubliceerd op 5 minuten leestijd
Interne documenten en bedrijfsdata worden pas bruikbaar voor AI wanneer ook herkomst, toegang en verantwoordelijkheid zijn geregeld. Retrieval-Augmented Generation, kortweg RAG, kan relevante bronfragmenten bij een vraag zoeken. Het maakt een antwoord alleen niet automatisch juist, veilig of actueel.
In een afgebakende proof of concept uit 2024 onderzochten we dit met financiële data van Schadenberg Groep. Die praktijkervaring liet vooral zien waar de echte ontwerpvragen liggen: welke informatie hoort bij de vraag, wie mag haar zien, hoe controleert een medewerker het antwoord en wie onderhoudt de oplossing?
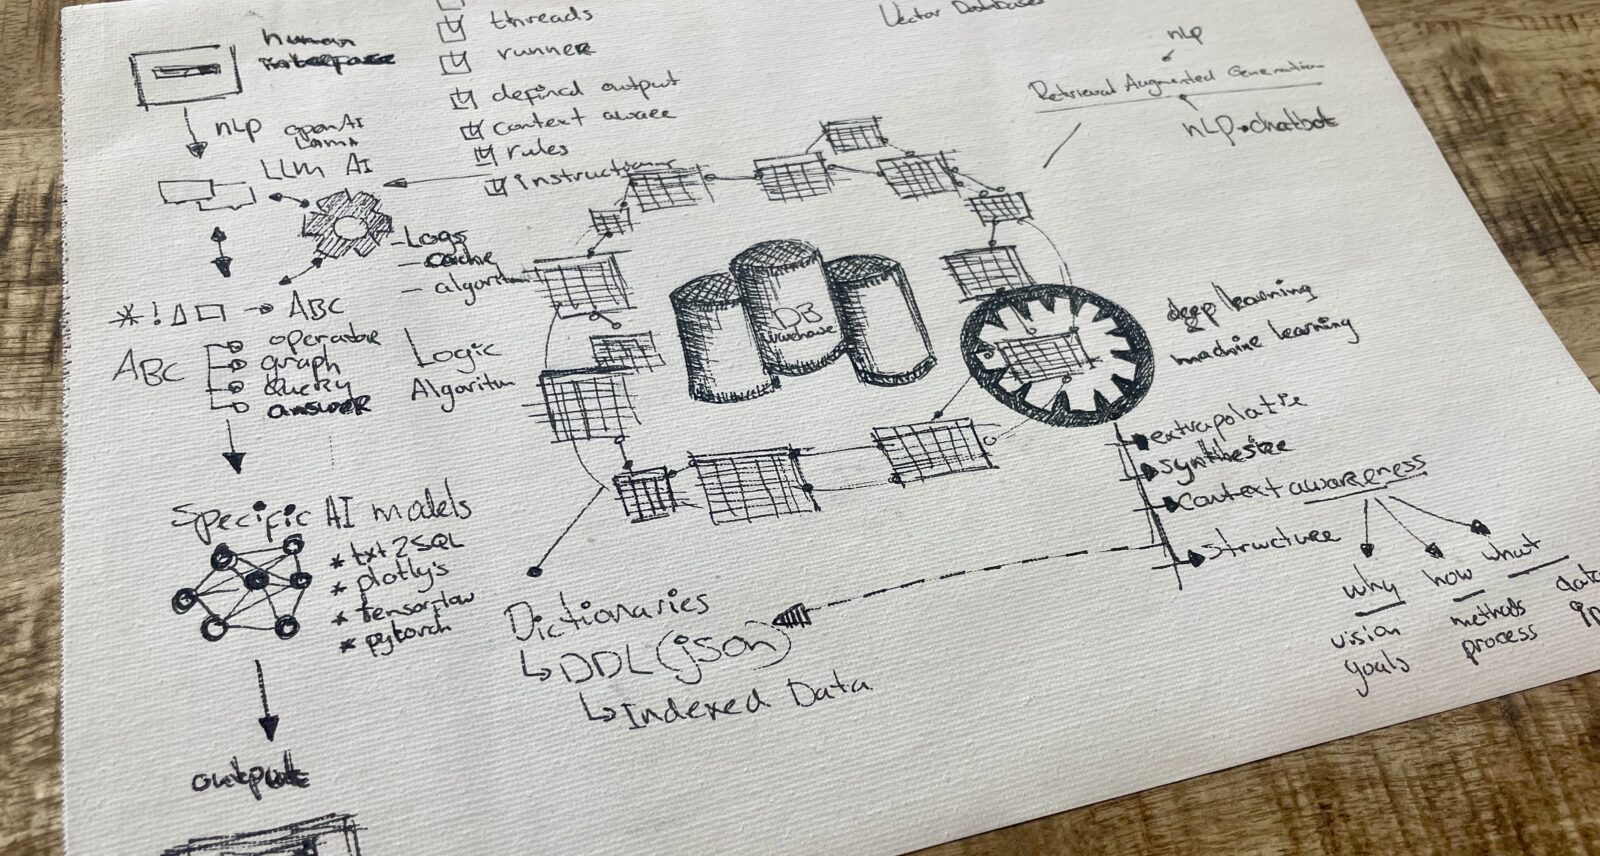
Wat RAG wel en niet doet
Een taalmodel formuleert tekst op basis van patronen die het tijdens de ontwikkeling heeft geleerd. Bij RAG krijgt het model daarnaast informatie die op het moment van de vraag uit geselecteerde bronnen wordt opgehaald. Het model wordt daarmee niet opnieuw getraind op ieder document. De toepassing zoekt eerst relevante passages en gebruikt die als context voor een conceptantwoord.
Dat onderscheid is belangrijk. Prompting geeft instructies mee aan een model. Retrieval zoekt informatie uit een broncollectie. Embeddings kunnen tekst omzetten in wiskundige representaties waarmee inhoudelijke overeenkomsten vindbaar worden. Modeltraining of fine-tuning verandert het model zelf. Een oplossing kan meerdere technieken combineren, maar iedere techniek heeft een andere functie, kostenstructuur en risicogrens.
RAG kan antwoorden beter herleidbaar maken wanneer de toepassing de gebruikte passages toont. Het voorkomt geen hallucinaties en garandeert geen privacy. Een verkeerd document, een verouderde versie of te ruime toegangsrechten kan nog steeds tot een onbruikbaar of ongewenst antwoord leiden.
Begin bij de werkvraag, niet bij de chatbot
“Maak al onze kennis doorzoekbaar” is te breed om verantwoord te ontwerpen. Een bruikbare eerste vraag is concreter: welke projectafspraak geldt voor deze wijziging, welke procedure hoort bij deze uitzondering of waarop rustte een eerder besluit?
Voor zo’n werkvraag brengen we zes onderdelen samen:
- Gebruiker en rol. Wie stelt de vraag en welke informatie mag die persoon vanuit de bronomgeving zien?
- Bronnen en versies. Welke documenten of systemen zijn leidend en wie is eigenaar van actualiteit?
- Vindbaarheid. Hoe worden relevante passages gevonden zonder de betekenis van tabellen, bijlagen of metadata te verliezen?
- Antwoordgedrag. Hoe toont de assistent bronsteun, onzekerheid, conflicten en ontbrekende informatie?
- Menselijke controle. Wanneer kan iemand bevestigen of corrigeren en wanneer moet de vraag naar een verantwoordelijke collega?
- Beheer. Wie bewaakt toegang, bronverversing, evaluaties, kosten, logging en modelwijzigingen?
Niet iedere vraag hoort in een gesprek. Wanneer de benodigde informatie vooraf vaststaat, werkt een gerichte pagina, zoekfunctie of formulier vaak rustiger. Een conversatie-interface past wanneer verschillende formuleringen, vervolgvragen en context bepalen welke route of actie passend is.
Veiligheid hangt af van de hele gegevensroute
De uitspraak dat data “niet met het model wordt gedeeld” is vaak te eenvoudig. Dat hangt af van de gekozen architectuur en afspraken: waar documenten worden opgeslagen, waar zoekindexen en embeddings staan, welke informatie als context naar een modelprovider gaat, hoe lang invoer en uitvoer worden bewaard en welke partijen toegang hebben tot logging en beheer.
Een private of lokale opstelling kan in een specifieke situatie passend zijn, maar is geen doel op zichzelf. Soms bieden bestaande bedrijfsplatformen passende contractuele en technische grenzen. Soms vraagt de gevoeligheid, beschikbaarheid of integratie om meer eigen infrastructuur. De keuze volgt uit gegevensclassificatie, dreigingsbeeld, gebruikersrollen, beheerbaarheid en kosten.
Praktische maatregelen zijn onder meer minimale toegang, scheiding tussen omgevingen, versleuteling, controleerbare logs, bewaartermijnen en expliciete afspraken over verwerking. De NIST AI Risk Management Framework helpt risico’s gedurende de levenscyclus te organiseren. De OWASP-richtlijnen voor generatieve AI beschrijven technische risico’s zoals prompt injection en het onbedoeld prijsgeven van informatie.
Test met echte vragen en ontworpen fouten
Een vriendelijke demo met drie voorbeeldvragen zegt weinig over dagelijks gebruik. Een representatieve evaluatieset bevat gewone vragen, onduidelijke formuleringen, verouderde documenten, conflicterende passages, onbevoegde verzoeken en vragen waarvoor de bronbasis onvoldoende is.
Domeinexperts beoordelen vervolgens niet alleen of het antwoord prettig leest. Zij kijken of de bron het antwoord werkelijk ondersteunt, of belangrijke context ontbreekt, of ongewenste informatie zichtbaar wordt en of het voorgestelde vervolg past bij hun verantwoordelijkheid. “Ik weet het niet op basis van deze bronnen” kan daarbij beter productgedrag zijn dan een aannemelijk antwoord.
Wat we leerden van de Schadenberg-proef
De historische Fusion AI-proef uit 2024 bracht 67.358 facturen, 80.418 transacties en 3.915 leveranciers samen in een afgebakende onderzoeksomgeving. Facturen werden met OCR verwerkt, gegevens werden gestructureerd en gebruikers konden vragen stellen over onder meer uitgaven en leveranciers. Het antwoord bleef afhankelijk van de kwaliteit en betekenis van de brondata.
De proef maakte ook beperkingen zichtbaar. Dataverrijking en classificatie vroegen veel controle en rekenwerk. Een taalmodel kende de database niet vanzelf; tabellen, relaties en begrippen moesten expliciet worden beschreven. Gegenereerde zoekopdrachten vroegen technische begrenzing voordat zij op data mochten worden uitgevoerd. Vragen, antwoorden en fouten moesten worden beoordeeld om instructies en bronselectie te verbeteren.
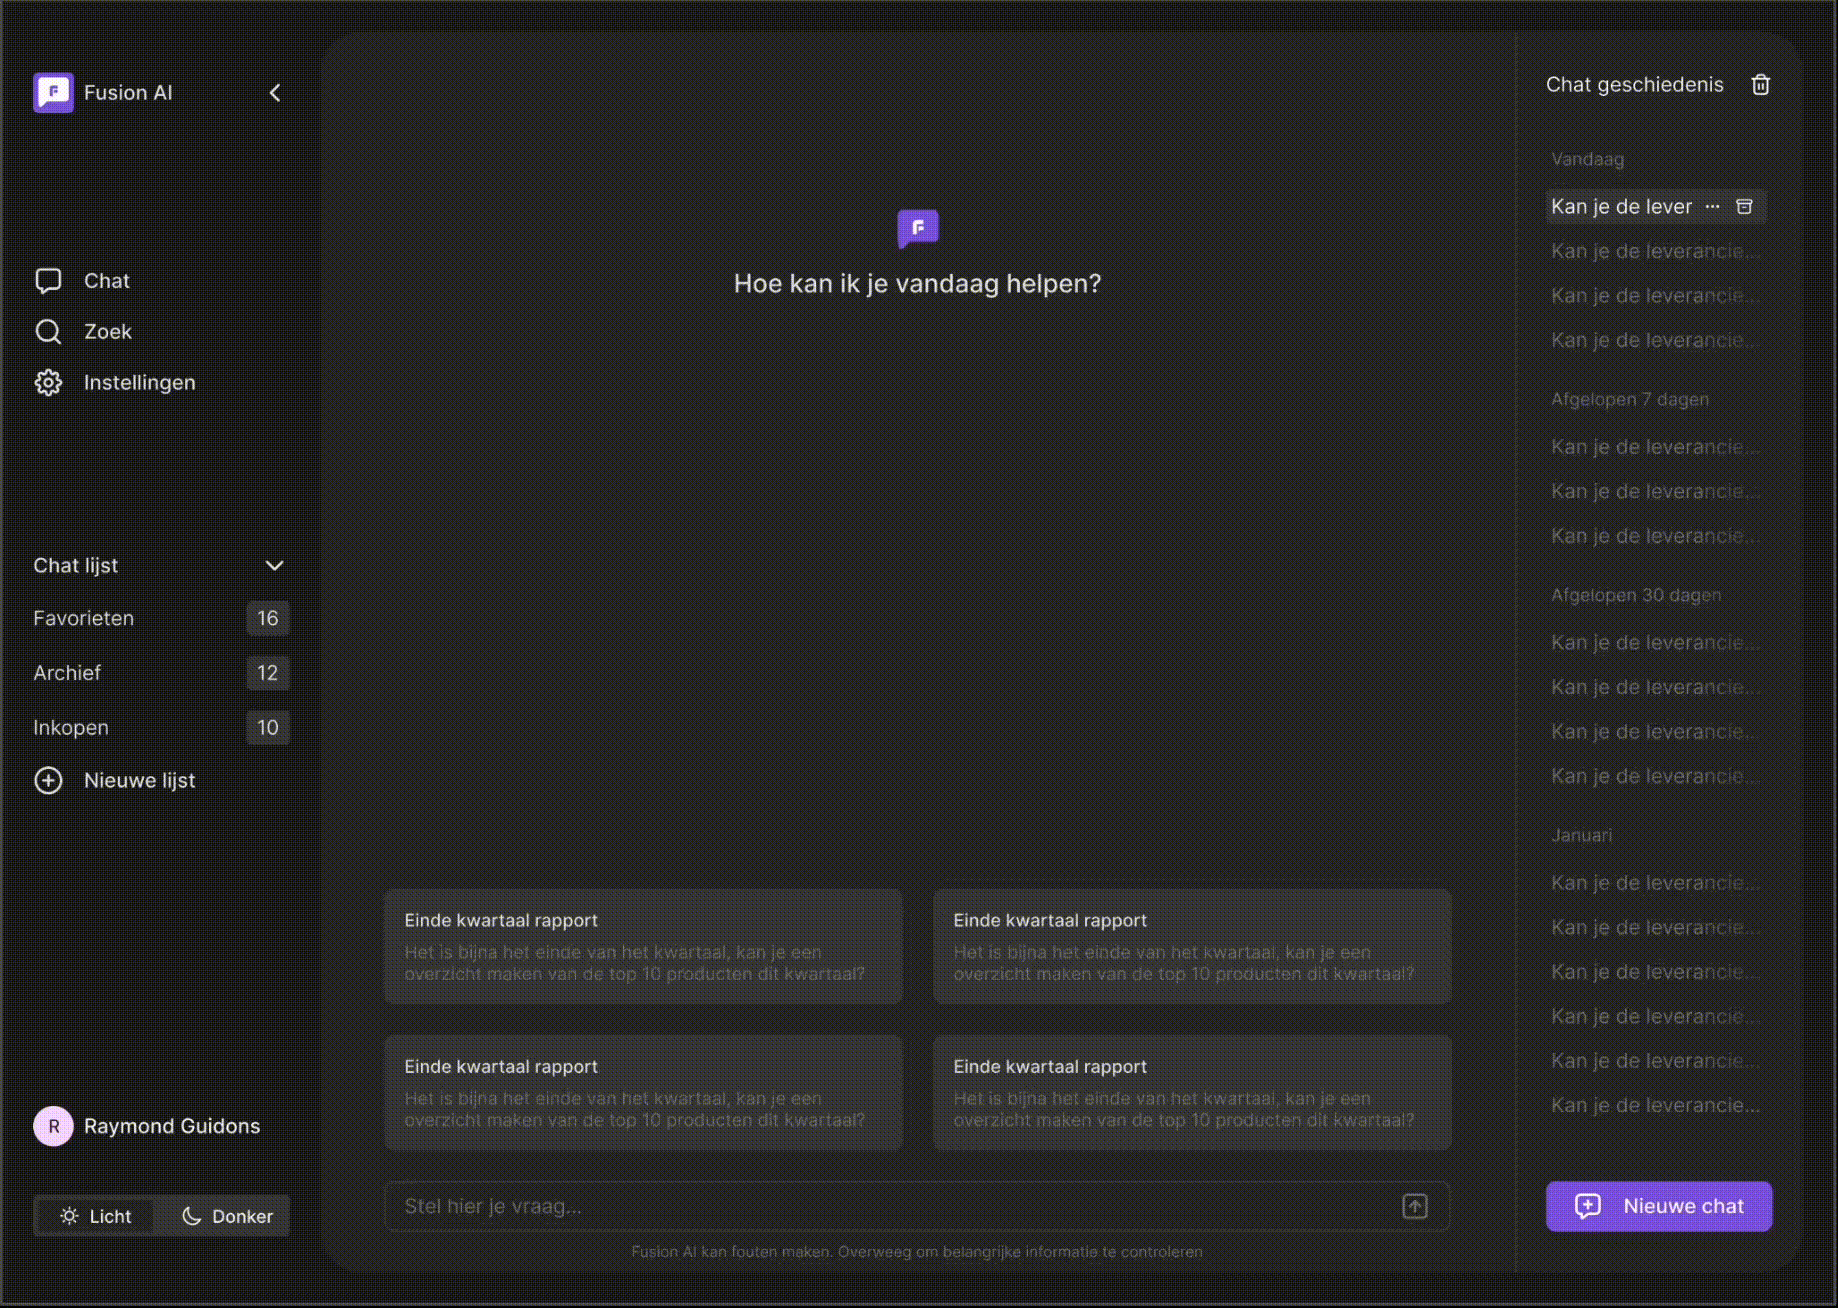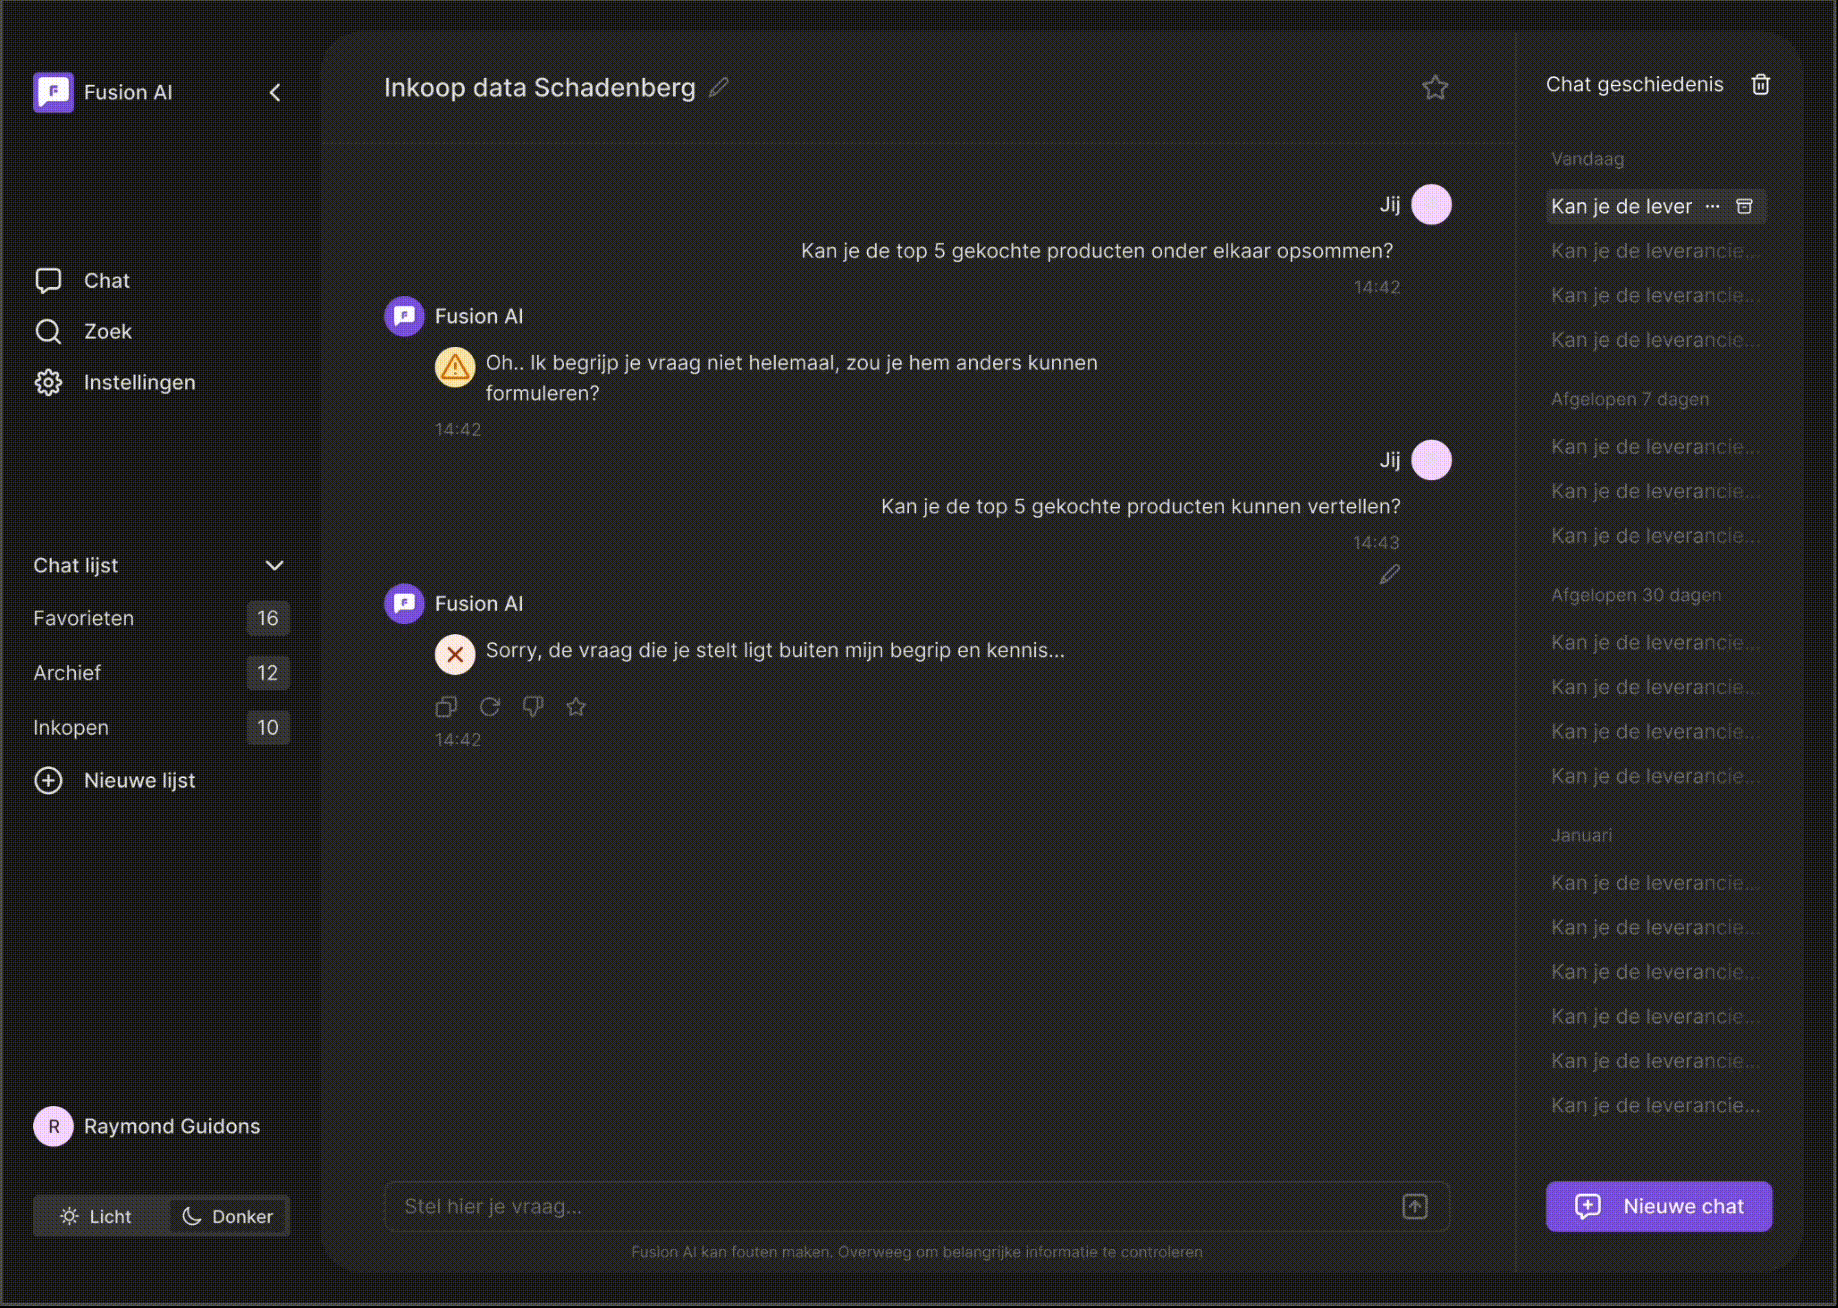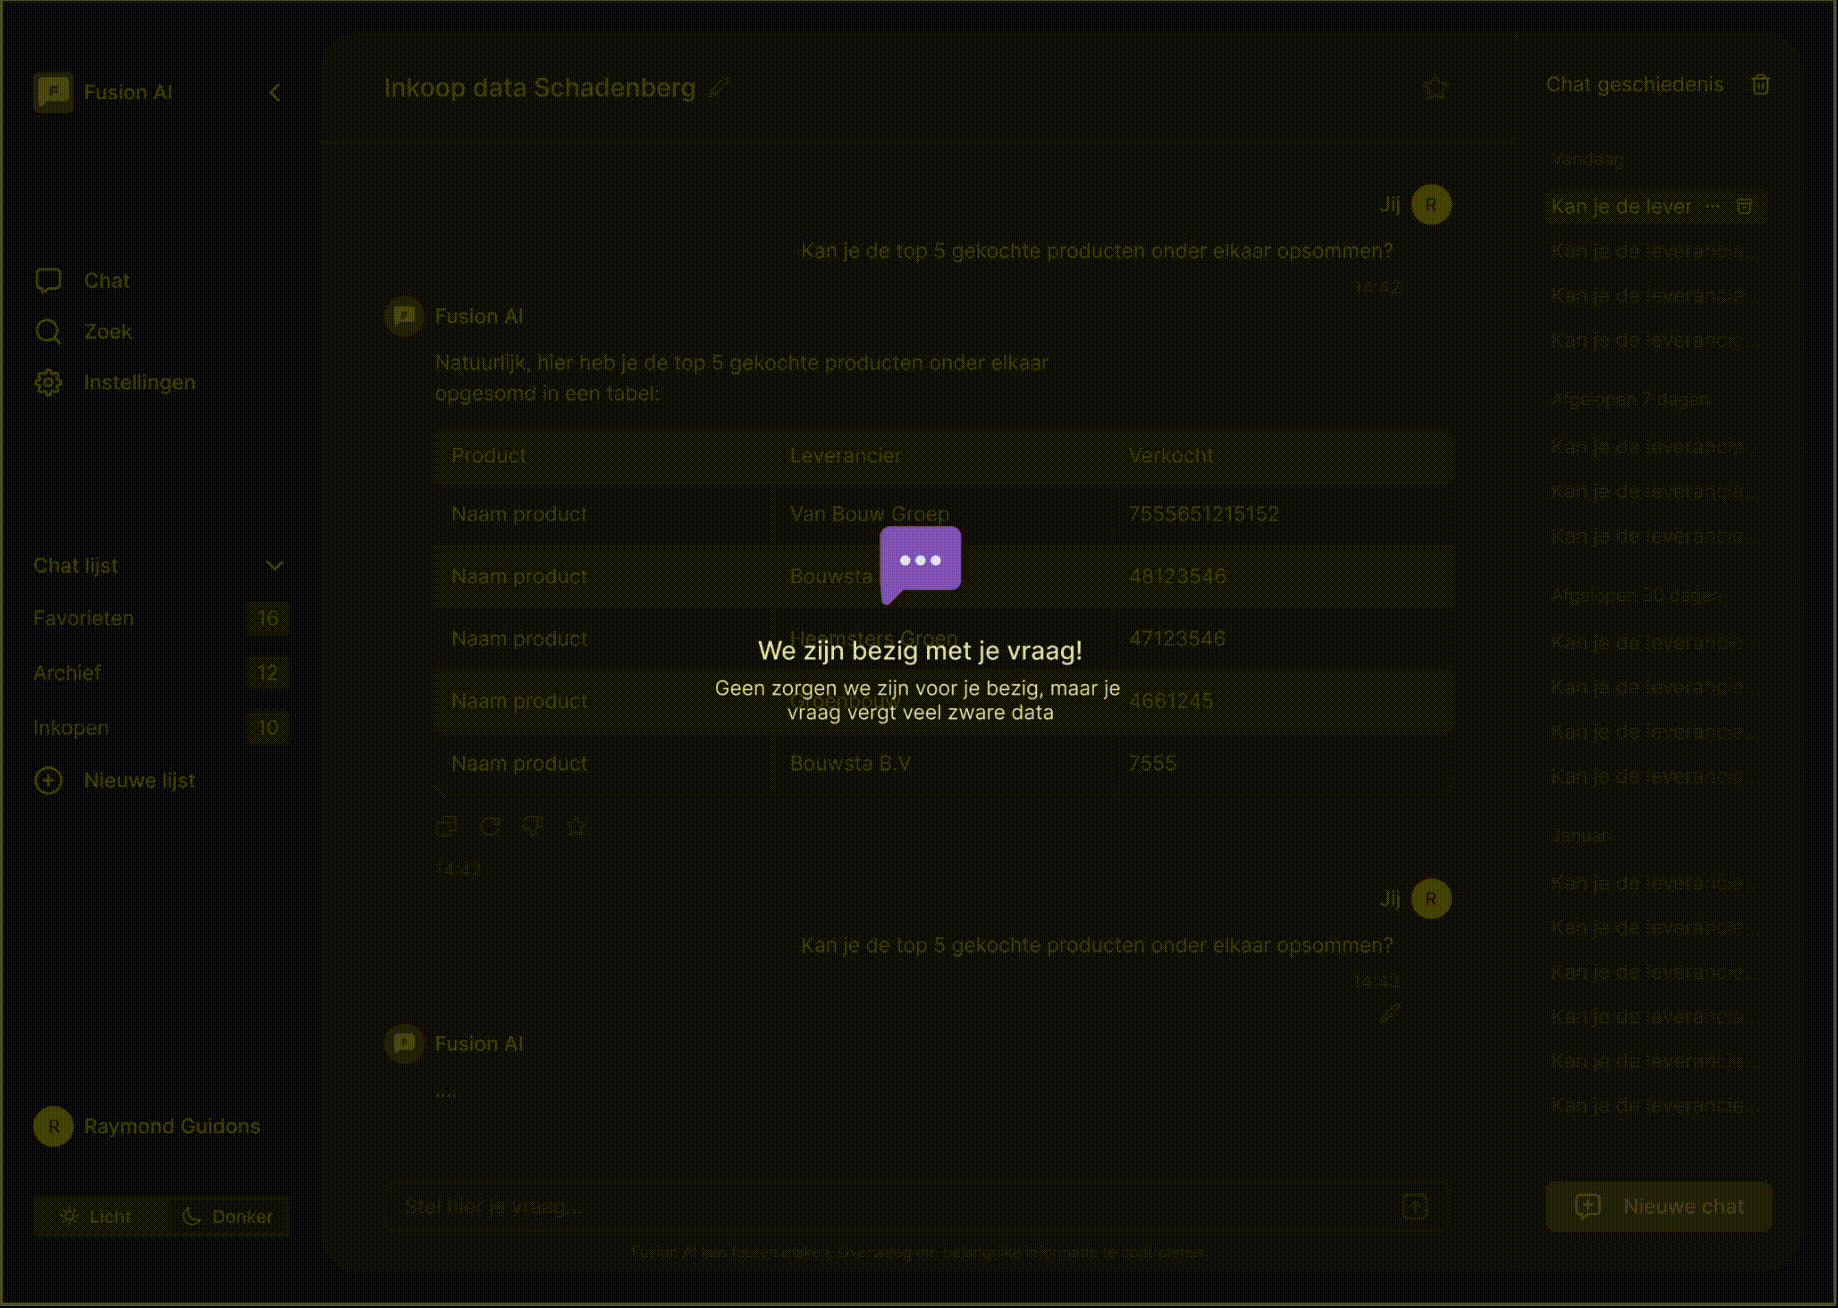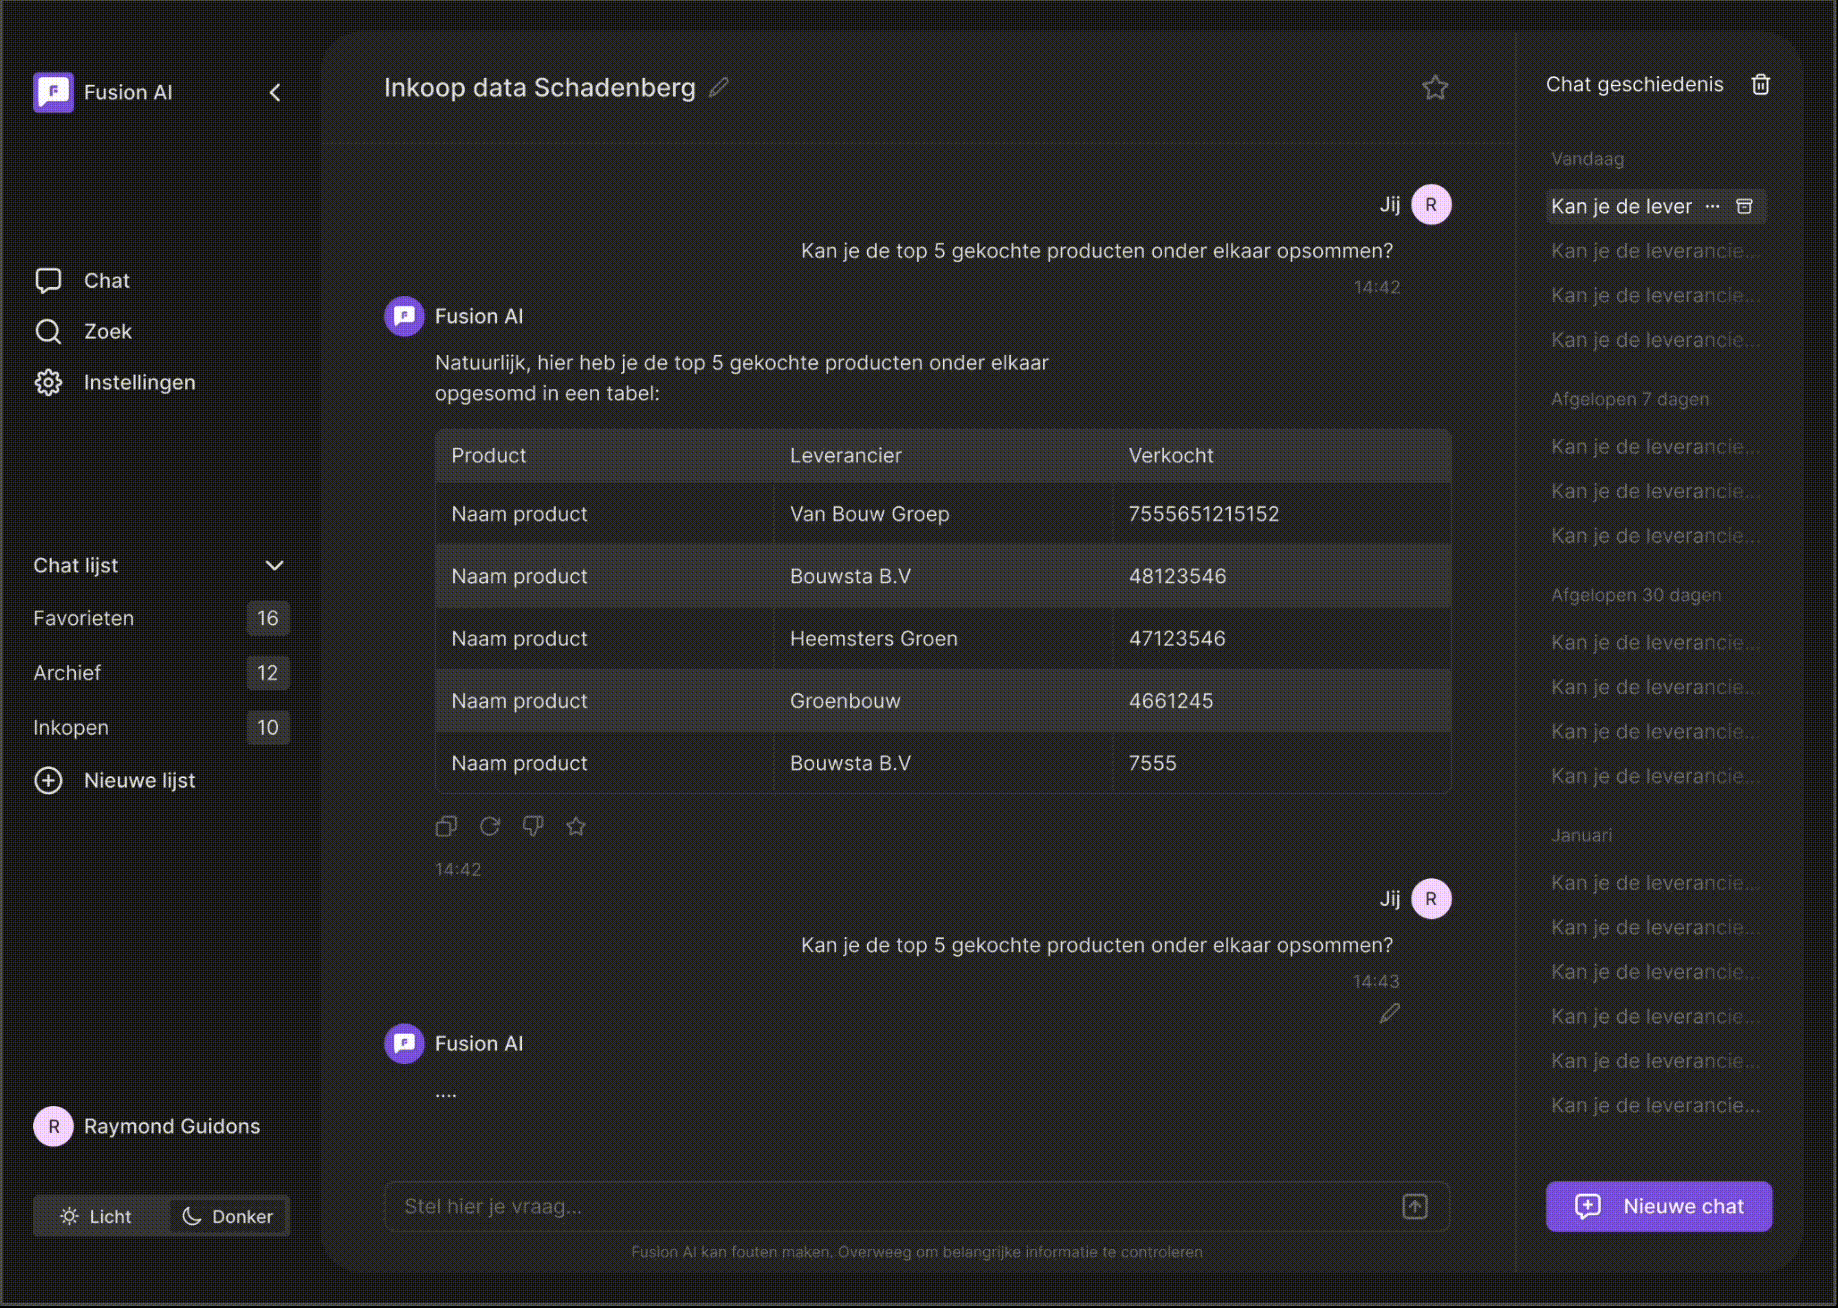
Deze proof of concept bewijst geen algemene kostenbesparing of foutloze kennisassistent. Hij gaf inzicht in de haalbaarheid, de datakwaliteit en de werkstromen die verdere ontwikkeling verdienden. Precies daarvoor is een beperkte proef bedoeld.
Wanneer deze aanpak past
Een kennisassistent is kansrijk wanneer een afgebakende groep vaak vergelijkbare vragen stelt, de relevante bronnen benoembaar zijn en een antwoord mensen helpt voorbereiden of controleren. Eerst de informatiehuishouding verbeteren is verstandiger wanneer documenten structureel verouderd zijn, bronnen elkaar tegenspreken of niemand eigenaar is van inhoud en rechten.
Voor interne kennisvragen hebben we onze aanpak uitgewerkt als het specialisme AI-assistenten voor interne kennis. Daar lees je hoe we één kennisvraag, bronnen, rechten, evaluatie en beheer samenbrengen. De Baudex-case toont hoe broncontext en menselijke beoordeling in een concrete bouwtoepassing samenkomen.
Gaat het vooral om het gesprek zelf, de vervolghandeling en een passende menselijke route, bekijk dan Conversatie-interfaces.
Wie eerst het gegevensfundament wil begrijpen, kan verder bij Data science. Voor vragen over toegangsgrenzen, verwerking en structurele verantwoordelijkheid sluit Beveiliging en privacy aan.
Bronnen voor verdere verdieping
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, de oorspronkelijke RAG-publicatie.
- NIST AI Risk Management Framework, voor risico- en levenscyclusbeheer.
- OWASP Top 10 for LLM Applications, voor veelvoorkomende technische risico’s.